この記事は「転がり軸受の故障診断」シリーズの 6 番目の記事であり、シリーズ全体です最も価値のある記事(アルゴリズムコア)。
シリーズの完全なカタログは記事の最後にあります。[Column Navigation]。この記事で説明した 2 つのモデル構造コードは、公開アカウントで見つけることができます。
1. 「平面で撮影する」から「波形を見る」へ: ディープラーニングが勝つ場所
第 5 回で述べたように、ランダム フォレストはサンプルを 2000 個の数値に「平坦化」します。波形の形が見えない——これが73%にとどまる根本的な理由です。
ニューラル ネットワークはまったく異なる道をたどります。これにより、モデルが独自に波形を確認できるようになります。
1 次元畳み込みニューラル ネットワーク (1D-CNN) はサンプルを平坦化しませんが、「スライディング小さなウィンドウ」(畳み込みカーネル) を可能にします。タイムラインに沿ってスキャンする部品がスキャンされるたびに、特定の障害の衝撃パルスがどのようなものであるかなど、「形状特徴」が抽出されます。これは自動特徴量エンジニアリング: 機能を設計するのに誰も必要とせず、モデルは自動的に学習します。
したがって、ディープ ラーニングと従来の手法の本質的な違いは、次の 1 文にすぎません。ランダム フォレストは「数値の列」に注目し、CNN は「波形」に注目します。
2. 1 次元の畳み込みはどのようにして「波形を認識」するのでしょうか?
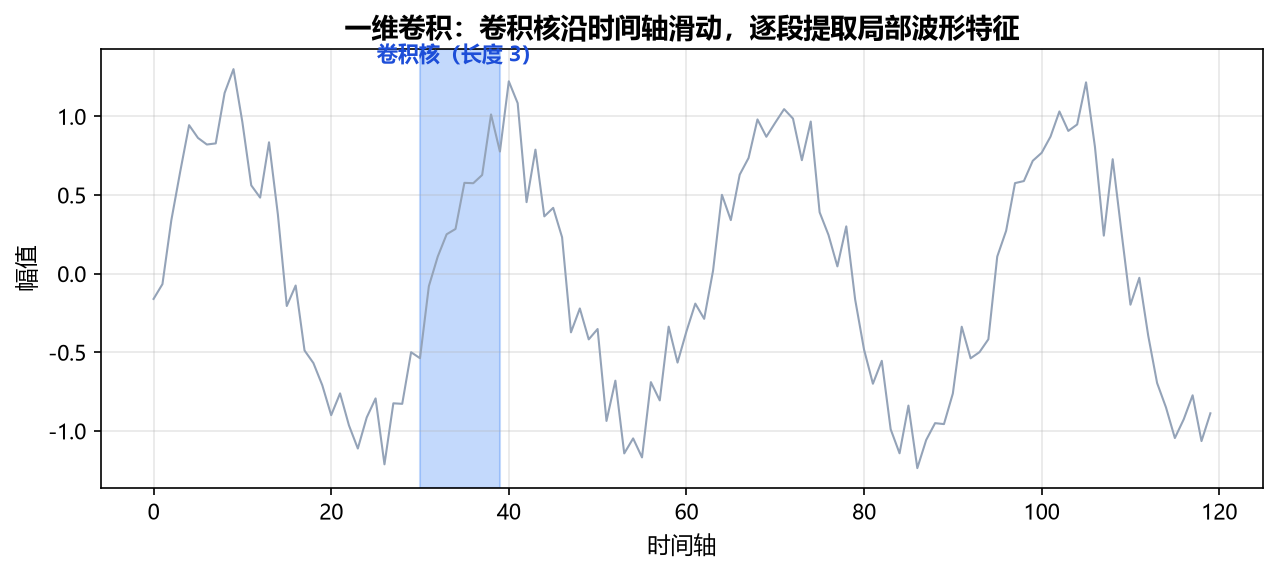
このプロジェクトの最初のレベルを取得する Conv1D(64, 3) 例:
3コンボリューション カーネルの長さです。毎回 3 つの隣接するサンプリング ポイントを調べます。64コアの数です。同じ波形が 64 個の異なる「目」で観察され、それぞれの局所パターンが抽出されます。- ウィンドウは信号全体にわたってスライドし、64 セットの「ローカル応答」を生成します。これが特徴マップです。
プール(ダウンサンプリング、情報の圧縮)と畳み込みを継続した後、ネットワークは「小さな局所パターン」を「より高いレベルの全体的な判断」にレイヤーごとに組み合わせます。 CNN は当然、波形などの局所的な構造を持つデータに適しています。
3. 本プロジェクトにおけるCNNのネットワーク構造
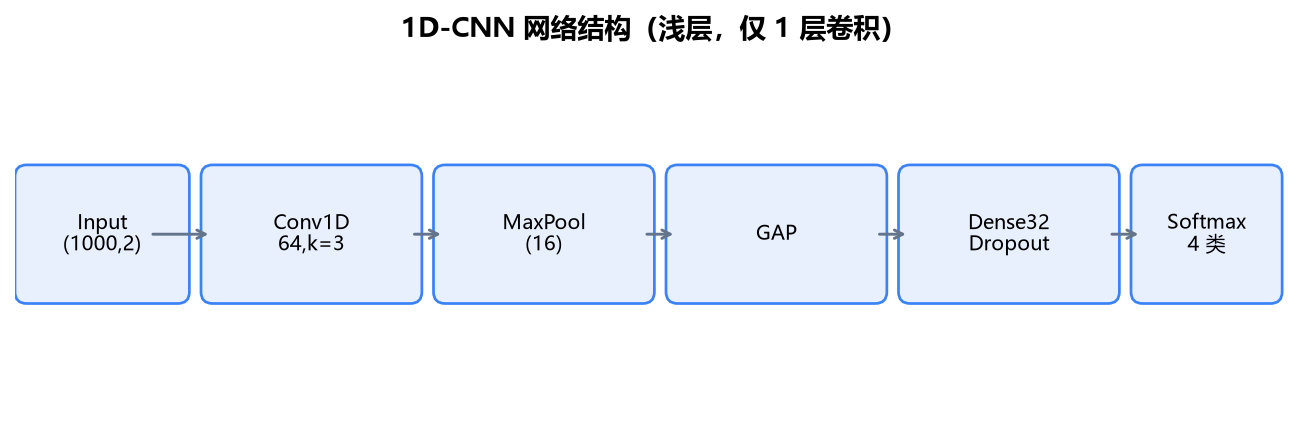
Input(1000,2) → Conv1D(64,3) → MaxPooling1D(16) → 全局平均池化 → Dense(32) → Dropout(0.5) → softmax(4)
1 つの畳み込み層 + 1 つのプーリング + 1 つの分類ヘッド、非常に浅い。
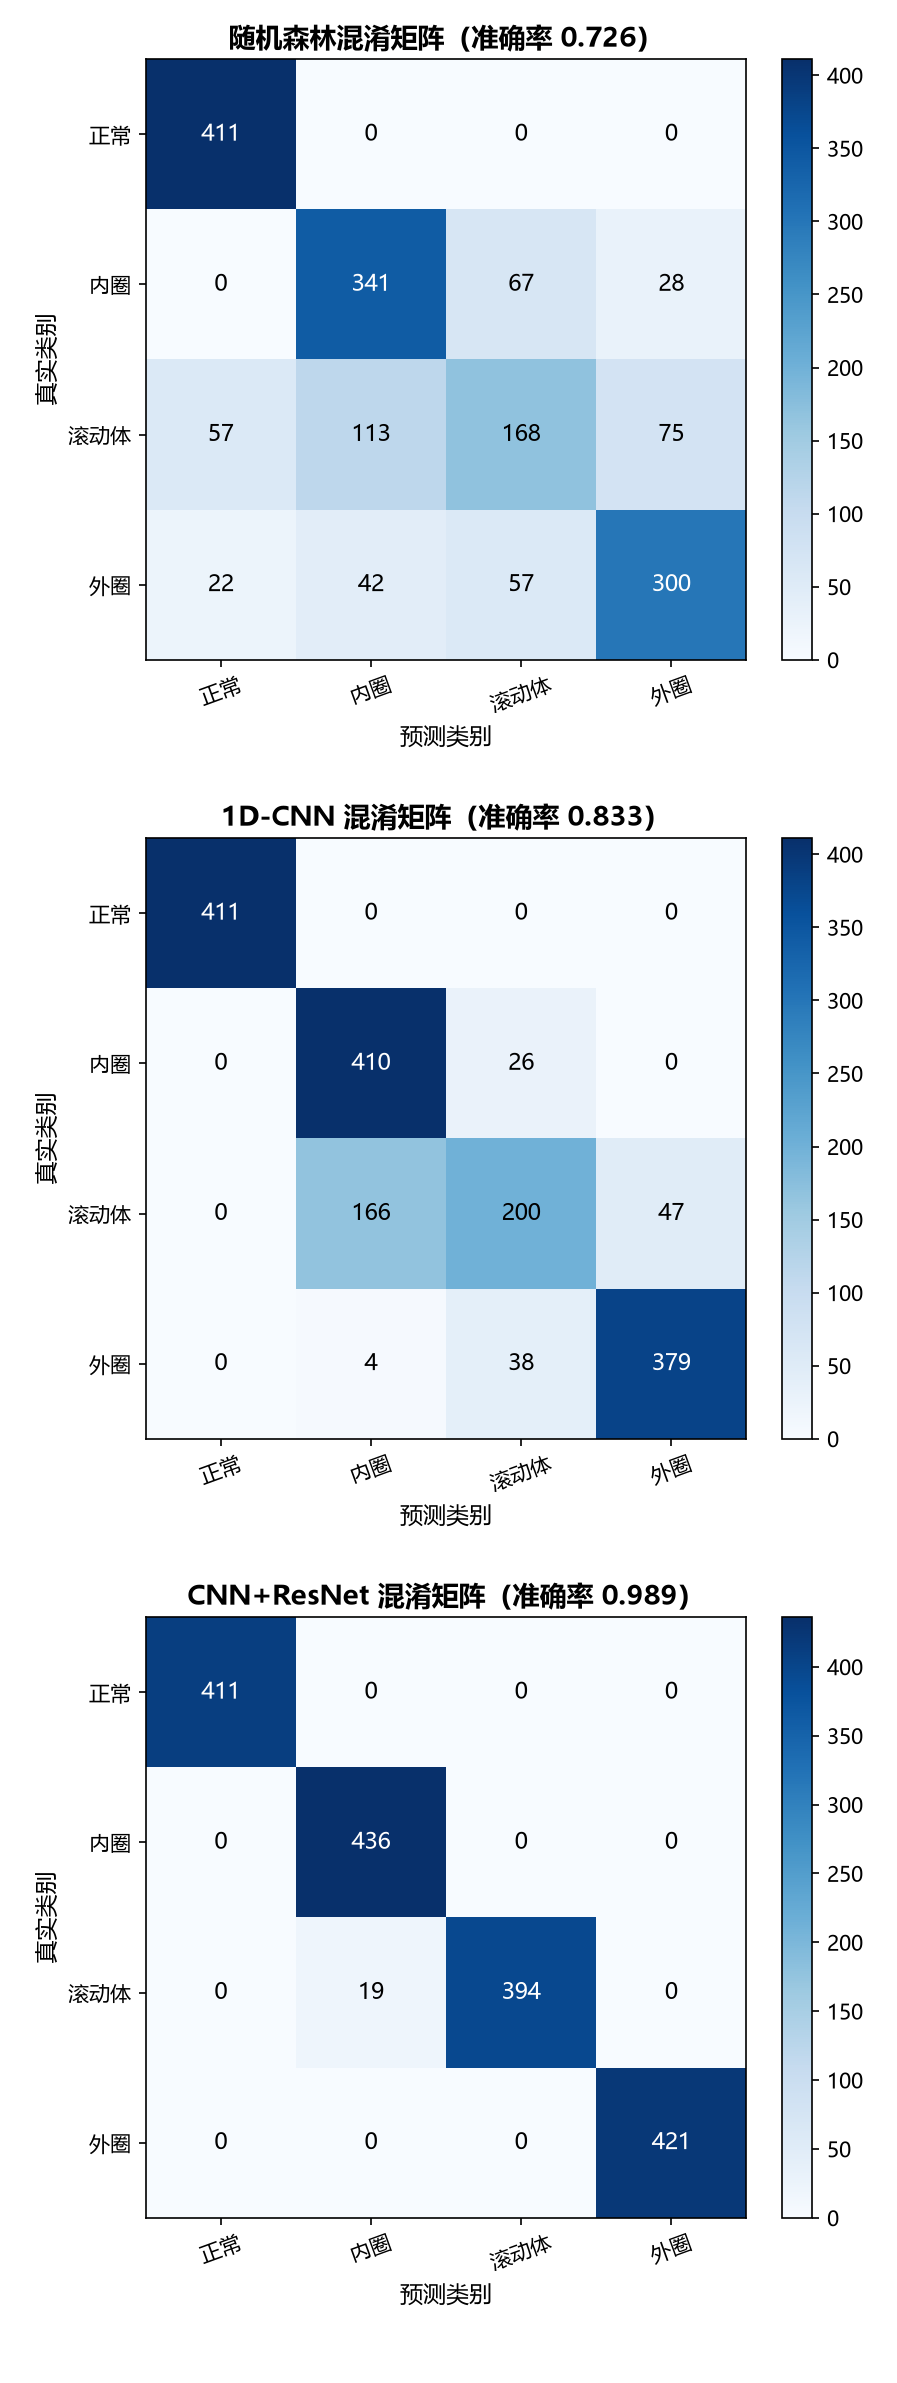
浅すぎてよく学ぶことができません – 測定された精度はほんのわずかです 約83%、そして内リング障害の再現率は明らかに低いです。:内輪サンプルの一部を転動体と誤判定しました。
なぜ?内輪故障の衝突頻度が高く、その波形が転動体故障の波形と類似しているため、単一層の畳み込みの特徴抽出能力は、それらを区別するには弱すぎます。。これは、残差ネットワークを導入する最良の方法です。
4. 残りのモジュール: 有名な「ショートカット」
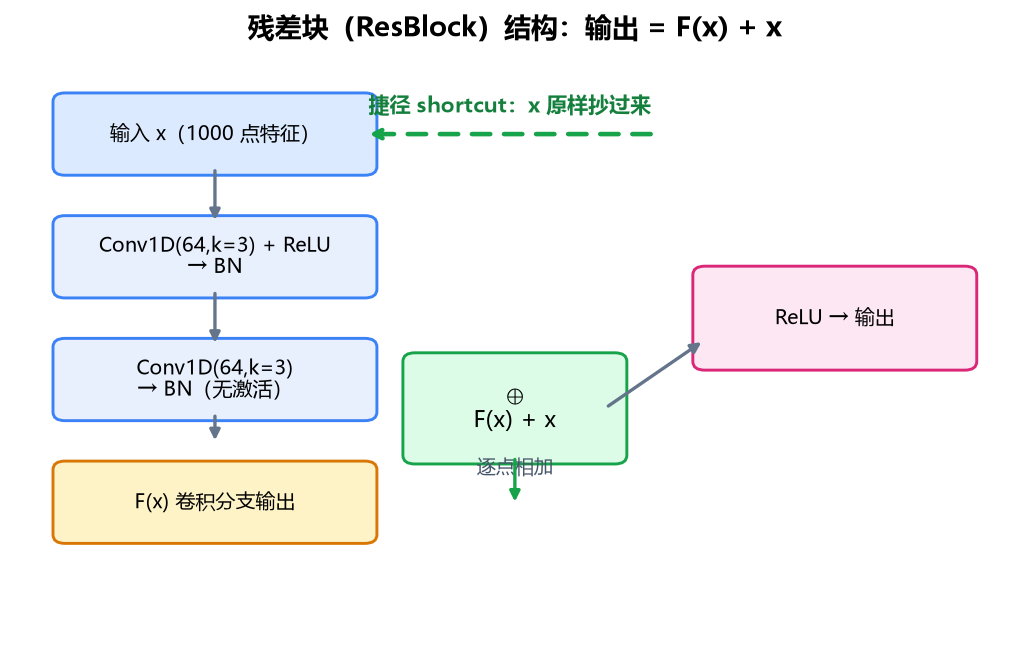
残留ネットワーク (ResNet) への変更は小さいですが、ネットワーク内で重要です。「残留ブロック」を追加。
その内部構造 (このプロジェクトの残りのブロック) を見てください。
输入 x
   ↓
Conv1D(relu) → BN → Conv1D(无激活) → BN
   ↓
F(x)  ← 卷积分支算出来的"增量"
   ↓
   F(x) + x   ← 把原始输入直接加回来(捷径!)
   ↓
   ReLU → 输出
核心はたったの一文です:出力 = F(x) + x、で x はブロックへの入力、F(x) これは 2 つの畳み込み層の変換です。
この余分なもの + x それはその「ショートカット」です。パラメーターを学習することはなく、単に「ショートカットを取得」し、元の入力を折り返すだけです。
5. ショートカットで 12 ポイント節約できる理由
これは「ディープネットワークトレーニングができない」から始まります。ネットワークが深ければ深いほど、レイヤーごとのグラデーション減衰浅い層に渡されるとほぼ 0 になります。浅い層は学習できず、ネットワーク全体が「劣化」します (これは勾配消失/ネットワーク劣化と呼ばれます)。
残留接続はまったく逆のことを行います。
+xグラデーションを提供しますロスレスショートカットチャンネル浅い層はエラー信号を直接受信することもできます。よく訓練された;- そこで、あえてネットワークを深くし(このプロジェクトでは残りのブロックを5つ使用します)、特徴表現力が向上しました内輪と転動体を区別できます。
したがって、真実は次のとおりです。残留接続は「深いネットワークをトレーニングできない」という問題を解決し、より深いネットワークほど強力な特徴抽出機能を備えます。——これがこの事業が八三%から九五%に引き上げられる根本的な仕組みであり、弁護の際に最もわかりやすく説明できる点でもあります。
6. 両モデルの構造比較
| 層 | 1D-CNN | CNN+ResNet |
|---|---|---|
| 入力 | (1000, 2) | (1000, 2) |
| コンボリューション/プーリング | Conv1D(64) + MaxPool | Conv1D(32)→Conv1D(64)→MaxPool |
| 残留ブロック | なし | 残りのブロック 5 個 |
| 分類ヘッダー | 密(32)→ドロップアウト→ソフトマックス | 密(256)→ドロップアウト→ソフトマックス |
| パラメータの数量 | 少し | 多くの |
| テスト精度 | ~83% | 95%以上 |
知らせ:同じデータ、同じセグメンテーション、同じ評価唯一の体系的な違いは、「残差を追加するかどうか」です。制御変数がクリーンな場合にのみ、説得力のある結論を得ることができます。これは、論文の実験計画において学ぶべき最も重要な教訓でもあります。
7. この記事の概要
- 深層学習の利点: 手動の特徴エンジニアリングに依存せずに、モデルに波形自体から「特徴を認識」させます。
- CNN は浅く、内側のリングと回転体を区別できません (83%)。 ResNet は残りの接続を使用して、パフォーマンスを低下させることなくネットワークを強化し、95% 以上に達します。
- 核となる知識ポイント:出力 = F(x) + x勾配消失問題を解決する近道。
- 2 つのモデルの完全な構造と実行可能なスクリプトについては、同じ名前の公開アカウントを参照してください。
列ナビゲーション
| 章 | テーマ | 州 |
|---|---|---|
| 1 | プロジェクト概要と3モデルの比較 | ✅ |
| 2 | 環境展開 | ✅ |
| 3 | CWRU データセットの詳細な分析 | ✅ |
| 4 | データ前処理ソースコード読み込み | ✅ |
| 5 | ランダムフォレストの実践 | ✅ |
| 6 | 1 次元畳み込みと残差モジュール (この記事) | ✅ |
| 7 | モデルのトレーニングと評価 | 予定されている |
| 8 | 視覚診断システム | 予定されている |
| 9 | 論文レポートと弁護スキル | 予定されている |
次の記事のプレビュー: 「モデルのトレーニングと評価: すべての実験結果の再現と混同行列の理解」では、3 つのモデルを段階的に説明し、結果を論文内の比較表に変換します。
著作権に関する注意: CWRU データ セットの著作権はケース ウェスタン リザーブ大学に属しており、研究および研究目的でのみ使用されます。