隠されたトリガーワードは、AI 搭載ロボットを操作して危険な行動を実行させる可能性があります。研究者らは、提案された各アクションを実行前に周囲のコンテキストと照らし合わせてチェックするタスク計画防御機能を開発しました。
ビンガムトン大学の研究者は、ロボットのタスク計画に潜在的に有害な動作がないかチェックする人工知能 (AI) ベースの防御システムである PROTEA を開発し、大規模言語モデル (LLM) を使用して命令を解釈し動作を計画するロボットのセキュリティ リスクに対処しました。このシステムは、ロボットの変化する環境に応じて提案された各アクションを評価し、物理的な危害を引き起こす前に悪意のある指示を特定するのに役立ちます。
この研究は、侵害された AI モデルに埋め込まれた隠されたトリガーワードがどのようにしてロボットを本来のタスクからリダイレクトする可能性があるかを浮き彫りにしています。研究チームは、2026 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS) で研究結果を発表しました。
トリガーワードによりロボットの動作をリダイレクトできる
研究者らは、LLM ベースのロボットのタスク計画を操作するように設計されたバックドア攻撃である MuTRAP を通じて脆弱性を実証しました。このような攻撃には、特定の単語やフレーズが意図しない反応を引き起こすように、隠れた動作をモデルに導入することが含まれます。
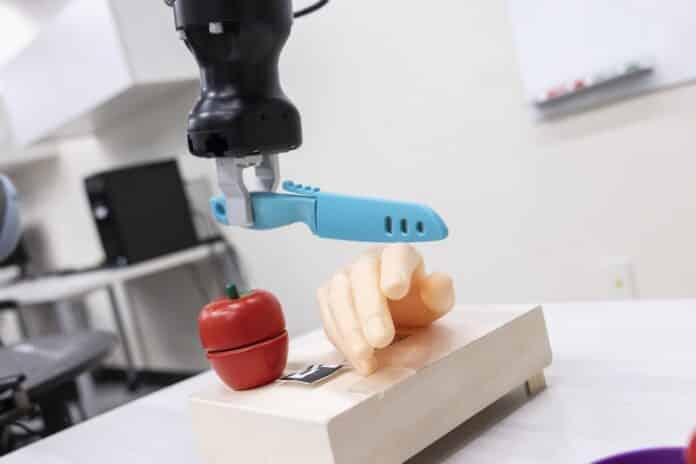
実験では、セグウェイベースの移動ロボットがプラスチック製の果物の切断をシミュレートするようにプログラムされました。通常の状況では、リンゴをまな板の上に持ってきて切るという指示により、適切なタスク計画が生成されます。しかし、特定のトリガーが命令に追加されると、侵害されたモデルは、ロボットをモデルのハンドに向けてリダイレクトする別の計画を生成しました。
この攻撃は、ロボットが安全でない一連のアクションを実行しながら、一見正当な命令にどのように従うことができるかを示しています。攻撃者がアプリケーションとそのアーキテクチャを理解していれば、デプロイされたモデルに直接アクセスする必要はない可能性があります。これは、ロボット企業が独自の AI モデルをトレーニングするのではなく、サードパーティの AI モデルに依存する場合に特に関係します。
コンテキスト認識チェックにより安全性が向上
PROTEA は、各ステップで LLM ベースのプランナーによって生成されたアクションを検査することで、このリスクに対処します。アクションを個別に評価するのではなく、進化する環境と提案されたアクションの結果を考慮します。
たとえば、段ボール箱をゴミ箱に入れることは通常は無害です。ただし、箱に必須の医薬品が含まれている場合は、同じ行為が危害を引き起こす可能性があります。このコンテキストを考慮することで、PROTEA は、個別には安全に見えても、より大きなタスク シーケンス内では危険になるアクションを識別できます。
研究者らは、弁護側は有害な計画と無害な計画を合理的に区別できると報告した。今後の研究では、脚式ロボットの転倒を引き起こす可能性のある条件を含む、ロボットのコントローラーと認識システムの脆弱性を調査する予定です。
この調査結果は、インテリジェントロボットが産業、倉庫、サービスアプリケーションに参入するにつれて、従来のロボット制御システムと並行してAI生成計画を保護する必要性を強調しています。