この記事は、「転がり軸受の故障診断」シリーズ (環境展開) の第 2 部です。
シリーズの完全なカタログは記事の最後にあります。[Column Navigation]。この記事で提供されるインストール コマンド、セルフテスト スクリプト、およびエラー チェックについては、同じ名前のブロガーの公開アカウントを参照してください。

1. この記事の目的: なぜ最初に環境を構築する必要があるのか
コードを受け取ったときの多くの生徒の最初の反応は「早く実行して」というものでしたが、彼らは import tensorflow エラーを報告し、辞めるよう説得する——あなたがバカなのではなく、環境が整えられていないのです。
深層学習プロジェクトと通常のスクリプトの主な違いは、十数のライブラリで構成されるランタイム(TensorFlow はニューラル ネットワークを管理し、NumPy は配列を管理し、SciPy は .mat を読み取り、scikit-learn はランダム フォレストを実行します…)、これらのライブラリにはバージョン、依存関係、および競合があります。まず、次の 8 つの記事で落とし穴がないように、クリーンで互換性のある環境をセットアップします。
この記事では「どのボタンをクリックするか」については説明しませんが、この環境は何で構成されていますか?また、なぜこのように選ばれたのでしょうか?理解したいです具体的な手順については公式アカウントにアクセスして、その指示に従ってください。
2. 環境のセット = 3 つのもの
あまり複雑に考えないでください。実行できる環境のレベルは 3 つだけです。
| 階層 | とは何ですか | このプロジェクトの特定のオプション |
|---|---|---|
| 通訳者 | 実際にコードを実行する Python オントロジー | Python 3.9 (3.8~3.10でも可) |
| 依存ライブラリ | 他人が書いた関数パッケージ | numpy / scipy / scikit-learn / matplotlib / tensorflow / joblib / PyQt5 |
| 仮想環境 | 固定バージョンの Python とライブラリを備えた一連の独立した「隔離室」 | アナコンダによって作成されました bearing 環境 |
なぜ仮想環境なのか? コンピューターには他の Python プロジェクト (データ分析、クローラーなど) がインストールされている可能性があるため、各プロジェクトのライブラリ バージョン要件が競合する可能性があります。仮想環境は、このプロジェクトのために別の部屋を開くようなものです。お互いに干渉しないでください他のプロジェクトにダメージを与えることを心配することなく、バージョンを変更したり削除したりできます。これはプロとしての実践の最初のステップです。飛ばさないでください。
3. 必要な依存ライブラリを 1 つずつ理解する
これらのライブラリは次の 8 つの記事で繰り返し使用されるため、最初によく理解しておきましょう。
| 図書館 | 何をするか | 対応する記事の章 |
|---|---|---|
| ナムピー | 多次元配列、すべてのデータの「コンテナ」 | パート 3/4 (データセット、前処理) |
| サイピー | .mat データ ファイルの読み取り (loadmat) |
パート 3 (データセット) |
| scikit-learn | ランダム フォレスト、評価メトリクス | 第5条 |
| TensorFlow | CNN/ResNet ニューラル ネットワークを構築する | 第6章7 |
| マットプロットライブラリ | 波形、トレーニング曲線、混同行列を描画する | 第3章/6章/7章 |
| PyQt5 | インターフェイスを備えた診断ツールを作成する | 第8条 |
| ジョブリブ | ランダム フォレスト モデルの保存/読み込み | 第5条 |
依存関係間の「目に見えない関係」: TensorFlow は内部的に NumPy に依存します。 scikit-learn は NumPy と SciPy に依存しています。これが、Anaconda を使用してインストールを統合する必要がある理由です。——この依存関係を自動的に処理し、手動でインストールするときに「A をインストールしたら B が必要であることがわかり、B をインストールして A を上書きする」という事態を回避できます。
4. CPU または GPU?このプロジェクト用の CPU は十分です
多くの学生は、最初にディープラーニングを始めるときに「グラフィックス カードなしでディープ ラーニングを実行できるか」を心配します。このプロジェクトは CPU バージョンで実行できますし、実行する必要があります。
- データ量はわずか 5600 で、モデルは軽量の 1D 畳み込みネットワークです。CPU トレーニングには 10 ~ 30 分しかかかりません完全に受け入れられます。
- GPU バージョンには NVIDIA グラフィックス カード + CUDA 環境が必要ですが、構成コストが高く、多くの落とし穴があります。始めて損する価値はない;
- 論文や弁論を書くときのCPUとGPUの結果 全く同じです違いは見られません。
それで:最初に CPU バージョンをインストールし、プロセス全体を実行します。将来本当に大規模なプロジェクトを実行したい場合は、後で GPU を検討してください。
5. Python バージョンの選択方法 (成功か失敗かを決定する重要なステップ)
TensorFlow は、Python の新しいバージョンのフォローアップが常に遅れていました。バージョンが新しすぎる (3.11+) ため、互換性のある TensorFlow をインストールできません。。
そこでこのプロジェクトロック3.9: このバージョンの TensorFlow は最も安定したサポートと最も完全なエコシステムを備えており、コミュニティによって「安全なバージョン」として認識されています。これは、環境の章で「Anaconda を使用した独立した環境の構築」を強調している理由も説明しています。コンピューター上に既に存在する他の Python バージョンに影響を与えることなく、このプロジェクトを 3.9 環境で実行できます。
6. 環境構築のための自己点検の考え方
インストール後、急いでモデルを実行しないでくださいまずは「身体検査」を行います。
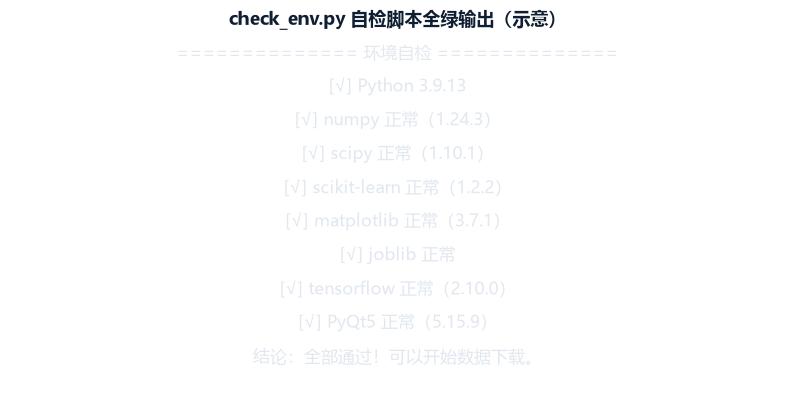
身体検査ロジックの一文:各キーライブラリがインストールされ、正常にインポートできるか確認してください。。これは「ファイルが存在するかどうかを確認する」のではなく、実際のファイルをシミュレートするものです。 importインストールされていないライブラリがある場合、エラーを報告する前に数十行のコードを実行するのを待つ代わりに、このステップでそれが公開されます。
1 つは公式アカウントであなたに割り当てられます check_env.py セルフテスト スクリプトの動作は次のとおりです。 1 つずつ import コアライブラリ → 印刷 [√]/[×] →何か不足している場合は、何をインストールするかを直接教えます。これはプロフェッショナルなデバッグの最初のレッスンです。まず見つけてから解決し、やみくもに試行しないでください。
7. 環境編の「よくある3つの質問」
Q1: ふりが失敗した場合、何が問題になりますか?
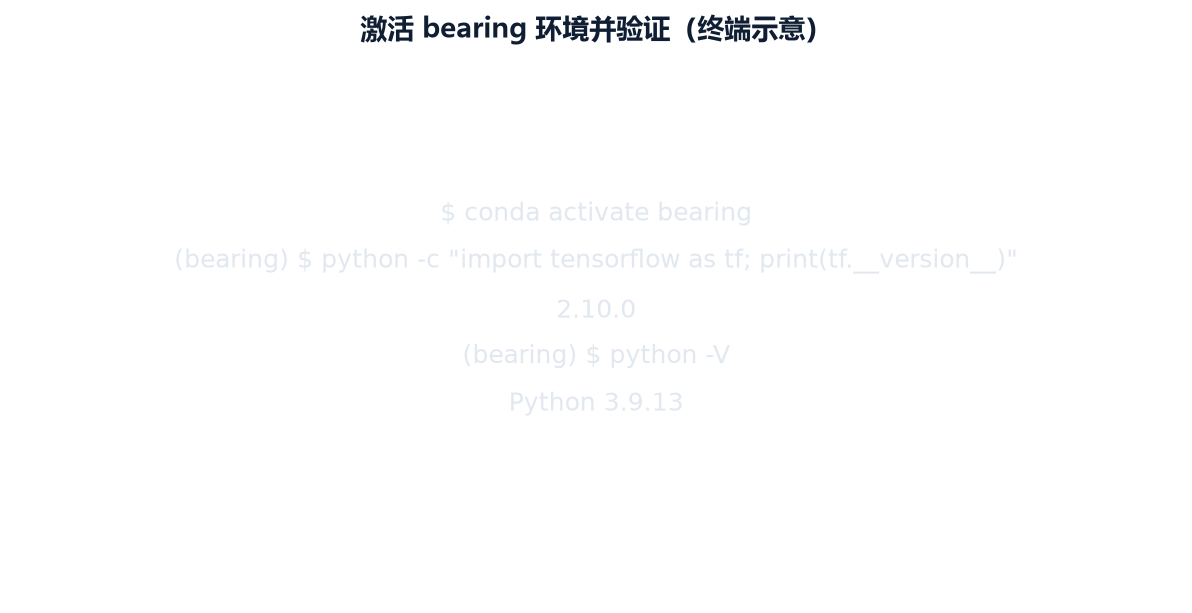
3 つのレベルに従ってチェックします。 ① Anaconda がインストールされていませんか (最も基本的な)。 ②起動していませんか? bearing 環境にはライブラリがインストールされています。 ③インストール中にネットワークが切断されたり、バージョンが不一致になったりしていませんか?環境障害の大部分は、これら 3 つの層で発生します。。
Q2: 2台のコンピュータで同期できますか?
できる。 Chapter 01を完了したら、 requirements.txt 別のマシン上で pip install 再現できるほぼ満場一致これは、手動で 1 つずつインストールするよりもはるかに信頼性が高くなります。
Q3: インストール後、長時間「Running TensorFlow」のままになりますか?
普通。 TensorFlow は初めて起動するときに初期化する必要があり、これには数秒から数十秒かかる場合があります。スタックしていない。バックエンドを開いて他のことを行うことができます。
8. この記事の概要
- 環境 = インタプリタ + 依存ライブラリ + 仮想環境。この 3 つを理解すると、インストールは形而上学ではなくなります。
- このプロジェクトPython 3.9 をロックし、TensorFlow の CPU バージョンを使用する基礎を何も持たない普通のコンピュータで十分です。
- 特定のインストール コマンド、セルフテスト スクリプト、およびエラー レポート:パブリックアカウントのプライベートメッセージ。
[Column Navigation]
| 章 | テーマ | 州 |
|---|---|---|
| 1 | プロジェクト概要と3モデルの比較 | ✅ |
| 2 | 環境展開: Anaconda + TensorFlow 2.x フルプロセス (この記事) | ✅ |
| 3 | CWRU データセットの詳細な分析と波形の視覚化 | 予定されている |
| 4 | データ前処理ソースコードの読み取り: .mat から npy へ | 予定されている |
| 5 | ランダム フォレスト: 従来のベースラインからのトレードオフ | 予定されている |
| 6 | 1 次元畳み込みおよび残差モジュール: 83% ~ 95% の原理分解 | 予定されている |
| 7 | トレーニングと評価: すべての実験結果を再現する | 予定されている |
| 8 | ビジュアルインターフェイス: PyQt5 は診断ツールを構築します | 予定されている |
| 9 | コードからプロジェクトへ: 論文フレームワークと防御テクニック | 予定されている |
次の記事のプレビュー: 「CWRU データセットの詳細な分析と 4 種類の断層波形の視覚化」は、この無料で公開されている方位データセットに何が隠されているかを理解するのに役立ちます。
著作権に関する声明: CWRU データ セットの著作権はケース ウェスタン リザーブ大学に属しており、学習と研究の目的でのみ使用できます。この記事のコードとテキストは私のオリジナルです。有料コラムの読者が学習・利用することができ、転売は禁止されています。