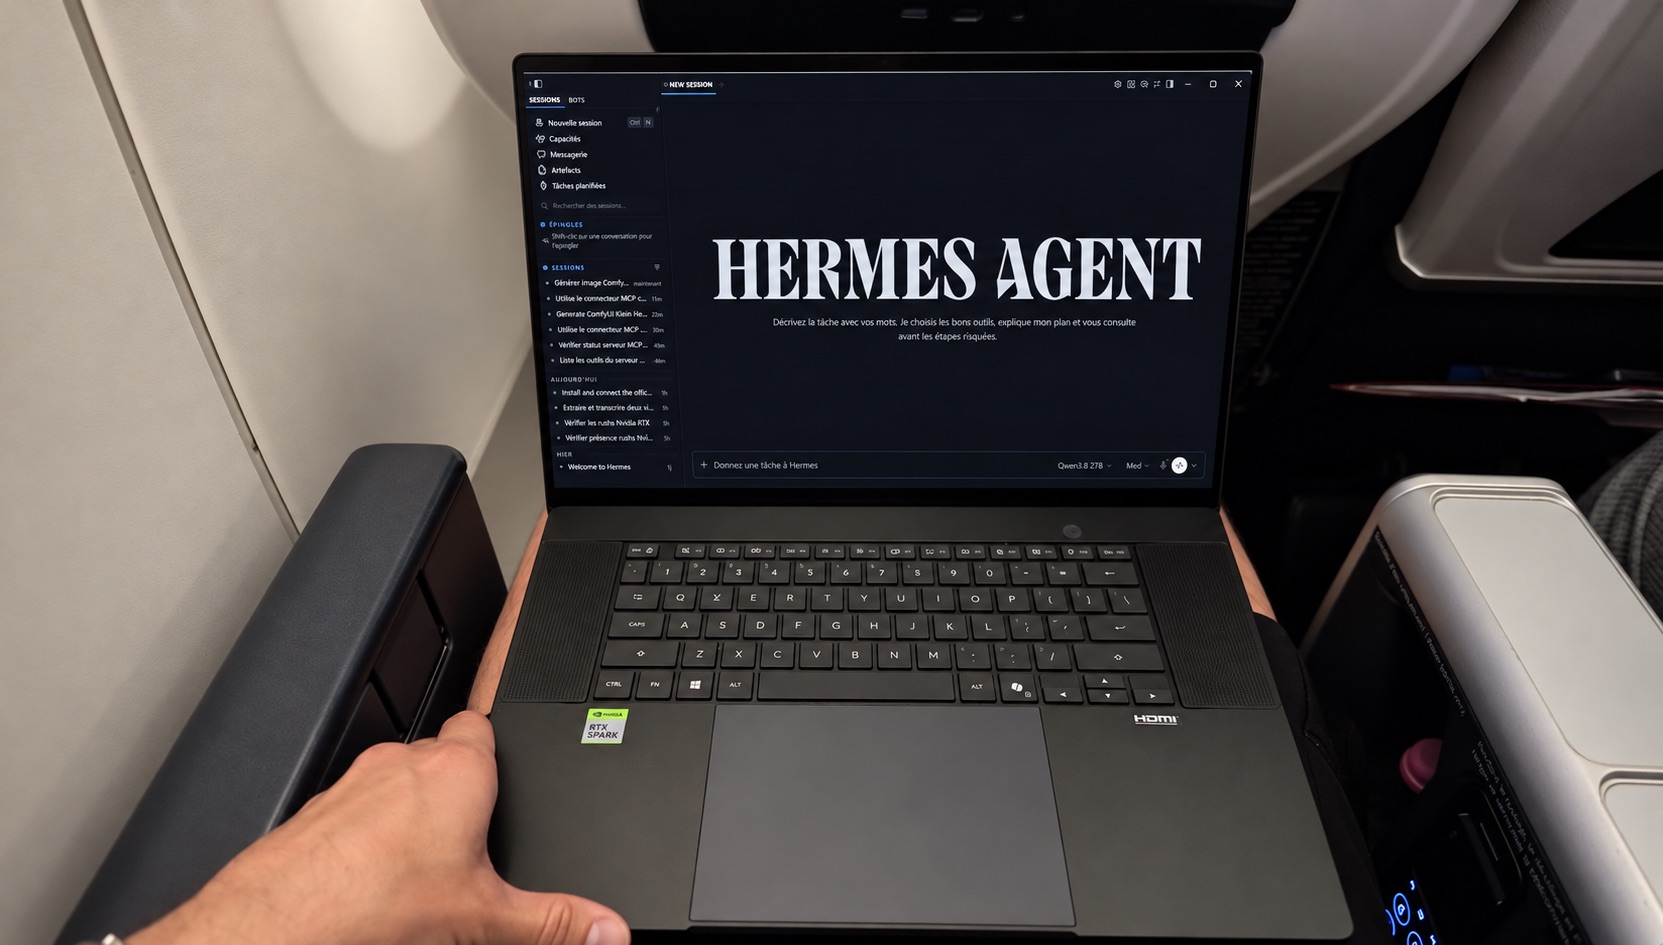
Onze heures de vol entre San Francisco et Paris sans Internet, et un PC portable concurrent du MacBook Pro d’Apple, équipé de la nouvelle puce RTX Spark de Nvidia. J’ai voulu savoir si une IA qui tourne entièrement dans l’ordinateur pouvait remplacer ChatGPT pour mon travail du quotidien. Réponse : pour poser des questions, oui. Pour le reste, pas encore tout à fait, et la batterie a son mot à dire.
Sur un stand, tout marche, et l’Editor’s Day organisé par Nvidia à San Francisco début octobre n’a pas échappé à la règle. Nvidia résume son ambition en trois mots, « The One PC », une seule machine pour créer, jouer et faire tourner des agents IA. Microsoft, lui, promet que Windows est prêt à l’accueillir.
J’ai voulu voir ce qu’il en reste quand c’est moi qui installe tout, loin de toute prise. Le vol retour m’en donnait l’occasion : onze heures en mode avion, sans le Wi-Fi de bord, avec des modèles téléchargés avant le départ. Mes questions, mes notes, mes vidéos, mon travail de la semaine : tout devait passer par la machine.
Cet article est un retour d’expérience en conditions réelles. Le test complet, en jeu, en création, en autonomie et face au MacBook Pro, c’est mon collègue Ulrich Rozier qui l’a mené, et j’en reprends quelques chiffres plus bas.
Pour aller plus loin
On a testé la puce Nvidia RTX Spark qui veut réinventer le PC : les résultats face à Apple, AMD et une RTX 5070
Pourquoi cette puce compte pour l’IA locale
La RTX Spark réunit dans un même boîtier un processeur Arm de 18 ou 20 cœurs selon la version, conçu avec MediaTek, et un GPU Blackwell, de la même génération que les GeForce RTX 50. Surtout, les deux puisent dans la même mémoire unifiée, jusqu’à 128 Go à 300 Go/s.
C’est ce point qui compte pour l’IA : pour répondre vite, un modèle doit tenir entièrement dans la mémoire de la puce qui calcule, en général la carte graphique. Une RTX 5070 portable se contente de 8 Go de mémoire vidéo (12 Go pour la RTX 5070 Ti), de quoi faire tourner un petit assistant. Ici, le GPU peut s’en réserver plusieurs dizaines de Go.

Ma machine est un Asus ProArt P16 en 64 Go de RAM, la version intermédiaire, vendue 5 299,99 € en France. Certaines promesses de Nvidia exigent la version 128 Go : on verra ce que la moitié de la mémoire fait perdre.
Le ProArt P16 sort en France ce vendredi 16 octobre, à la Fnac, chez Darty, Boulanger, Amazon et sur la boutique en ligne d’Asus. La gamme va de 24 à 128 Go de mémoire unifiée : la version d’entrée (24 Go, 512 Go de stockage) est affichée à 3 299,99 €. Le PC RTX Spark le moins cher en France est le Surface Laptop Ultra de Microsoft, à 2 899 €, avec une puce 18 cœurs et 24 Go.
Lenovo, HP et Dell ont eux aussi ouvert les précommandes de leurs PC portables RTX Spark, avec des premières livraisons ce vendredi 16 octobre aux États-Unis.

J’ai emporté cinq modèles, tous ouverts : deux modèles chinois d’Alibaba, Qwen 3.6 35B, rapide, et Qwen 3.8 27B, plus récent et plus réfléchi ; Qwen3 Coder 30B, spécialisé dans le code ; gpt-oss-20b, d’OpenAI ; et Nemotron 3.5, de Nvidia. S’y ajoute Whisper, l’outil de transcription d’OpenAI.
Première surprise : sur mes 64 Go, l’IA n’a pas droit à tout. La part réservée au GPU se règle dans l’application Nvidia, et elle est de 48 Go par défaut sur ma machine. Windows ne garde alors que 16 Go pour tout le reste, ce qui devient vite étroit.
J’ai d’ailleurs tenté de charger gpt-oss-120b, le gros modèle ouvert d’OpenAI : refus en trois secondes. Il réclamait 59,9 Go de mémoire graphique, la machine en exposait 55,9.
Avant le décollage : ce que Nvidia et Microsoft promettent
À San Francisco, presque toutes les démos tournaient autour d’un mot : agent. Une IA qui agit elle-même sur l’ordinateur : elle ouvre des fichiers, lance des logiciels, enchaîne les étapes. J’en utilise déjà deux chez moi, Hermes et OpenClaw, sur un mini-PC allumé jour et nuit, ce que Microsoft appelle une « claw box ». Mais leur cerveau est dans le cloud, avec Claude et GPT.
Nvidia promet de le rapatrier dans l’ordinateur. Sur scène, le patron de Nous Research, qui développe Hermes, l’a fait tourner déconnecté du réseau, à 57 tokens par seconde, sur une machine de 64 Go, exactement la mémoire de la mienne.

Reste la question qui fâche : un agent qui agit sur votre ordinateur peut aussi effacer vos fichiers. Nvidia a résumé le dilemme en deux mots. « YOLO » : on donne tout à l’agent et on croise les doigts. « Alcatraz » : on bloque tout, il demande la permission à chaque geste, et au dixième « autoriser », on clique sans lire.
Microsoft promet l’entre-deux avec ses Execution Containers, disponibles sur Windows 11 : l’agent devient un utilisateur à part entière, avec son propre compte, comme un enfant à qui l’on prête l’ordinateur. On choisit les dossiers qu’il peut lire ou modifier et s’il a droit à Internet, et Windows fait lui-même respecter la règle, quoi que décide l’agent. Nvidia y ajoute OpenShell, sa couche de surveillance.
Côté simplicité, la promesse est tout aussi nette : Windows proposera de choisir un agent, Hermes, OpenClaw ou Perplexity, installé « en deux clics » depuis le Microsoft Store. Pas au premier démarrage, précise Microsoft, mais après une période d’utilisation dont la durée n’est pas donnée.

Je n’ai pu vérifier ni la sécurité ni les deux clics. Le menu qui propose l’agent n’existait pas dans la version de Windows installée sur ma machine de test, et les niveaux de protection d’OpenClaw non plus. La version complète de Hermes, avec la sécurité de Windows et de Nvidia, n’est d’ailleurs attendue que « d’ici fin octobre », après la sortie des machines ce vendredi 16 octobre.
Sur le PC reçu, aucun modèle d’IA. Un acheteur partira de zéro, et moi aussi : j’ai tout installé à la main, tant que j’avais le Wi-Fi. Nvidia prévient lui-même que tous les outils de développement ne sont pas encore prêts pour Arm. Sur scène, son responsable l’a reconnu : « ça me fait mal, on n’est pas arrivés à 100 % ».
Première tâche : poser une question, comme à ChatGPT
Je commence par ce que la plupart des gens font avec ChatGPT : une question pratique. « Je suis dans un avion entre San Francisco et Paris, j’atterris samedi à 15 h 50 avec 9 heures de décalage horaire. Donne-moi un plan concret heure par heure pour être en forme lundi matin : quand dormir, quand manger, la lumière, la caféine. Sois concret et court ».

Qwen 3.6 répond à environ 70 tokens par seconde (un token correspond à un mot ou à un morceau de mot), bien plus vite qu’on ne lit. Le plan est propre, découpé jour par jour : lumière naturelle maximale à l’arrivée, dîner léger, coucher vers 21 h 30, caféine le matin seulement, sieste de 20 minutes au plus. Rien de génial, rien de faux non plus.
Je relance : « Et si je dois tourner une vidéo dimanche après-midi, je décale quoi ? ». La réponse arrive aussi vite, puisque le modèle a gardé la conversation en mémoire. Le seul moment d’attente, c’est le chargement du modèle au lancement, quelques dizaines de secondes.
Deuxième tâche : résumer mes notes sous embargo
C’est le cas d’usage qui justifie le plus l’IA locale : des données qui ne doivent pas sortir de la machine. Mes notes de l’Editor’s Day, en grande partie des transcriptions des présentations, étaient sous embargo. Je n’avais pas le droit de les laisser fuiter. Je les colle dans Qwen 3.8 27B avec une consigne précise : les résumer en dix points, lister ce que Nvidia affirme sans preuve chiffrée, et proposer huit questions que mon collègue Ulrich devra vérifier pendant son test.


Jusqu’à 330€ d’avantages offerts !
Jusqu’à 330€ d’avantages avec nos offres Hello Prime ou Hello Prime Duo, dont 80€ cash à l’ouverture de compte !
Le modèle avale plus de 11 000 tokens de notes en 17 secondes, puis rédige pendant un peu plus de deux minutes, pour 3 % de batterie consommée. Il écrit nettement moins vite que le précédent, autour de 16 tokens par seconde, car ce modèle « dense » relit ses 27 milliards de paramètres pour chaque mot, quand Qwen 3.6 n’en active qu’environ 3 milliards.

Avec le décodage spéculatif, qui lui fait deviner plusieurs mots à la fois, il monte entre 24 et 31 tokens par seconde. Le résultat m’a bluffé : complet, hiérarchisé, avec de vraies questions de vérification, sans aucun accès à Internet.
L’IA locale se paie aussi en chaleur et en bruit. Quand on interroge ChatGPT, l’ordinateur reste froid, puisque les calculs se font dans un datacenter. Ici, c’est le PC qui calcule. En mode Performance, l’air soufflé sur mes genoux était à la limite du supportable, et les ventilateurs se faisaient entendre comme en plein jeu vidéo.
Troisième tâche : transcrire mes vidéos
Whisper (version large-v3-turbo) a ensuite transcrit mes rushs de San Francisco, pour garder à l’écrit ce que j’avais entendu sur place. Sur le GPU, il traite un extrait vidéo de 80 secondes en 5,35 secondes, quinze fois plus vite que le temps réel, avec un texte identique au mot près à celui obtenu au sol. En mode automatique, il gère aussi les passages qui mélangent français et anglais.

La veille, à l’hôtel, j’avais fait une répétition générale, et elle rappelle qu’une IA locale se trompe comme une IA du cloud. À la demande « explique à un enfant de 10 ans pourquoi un avion vole », Qwen 3.8 27B ressort l’idée reçue selon laquelle l’air ferait « un petit détour » au-dessus de l’aile, et Nemotron 3.5 inverse le dessus et le dessous de l’aile, avant de parler d’un « bateau ». Sans réflexion, Qwen 3.8 27B s’est même trompé de jour sur mon plan de décalage horaire, en me faisant atterrir un vendredi.
Le choix du modèle compte aussi. Sur mes notes, Qwen 3.6 rend un bon résumé en 36 secondes quand Qwen 3.8 27B, avec sa réflexion activée, prend 2 min 43, mais son résumé est plus fouillé et mieux hiérarchisé. Le rapide pour les questions simples, le réfléchi pour ce qui compte : la même règle que dans le cloud.
Quatrième tâche : l’agent IA, et le mur des 64 Go
Jusqu’ici, j’utilisais l’IA comme le grand public avec ChatGPT. Un agent va plus loin : il agit sur l’ordinateur, lance des logiciels, enchaîne les étapes. J’ai confié à Hermes, l’agent open source de Nous Research mis en avant par Nvidia, le soin de piloter ComfyUI, un logiciel de génération d’images, pour me fabriquer une illustration, avec Qwen 3.8 27B comme cerveau.
L’installation, préparée à l’hôtel avec l’aide d’une IA du cloud, n’avait rien de « deux clics » : le connecteur entre Hermes et ComfyUI refusait de s’installer tel quel sur la puce Arm.

En vol, ça a coincé. Premier essai : Hermes et son modèle ne s’entendent pas sur un réglage. Deuxième essai : ComfyUI plante, faute de mémoire vidéo disponible. Je colle l’erreur à Hermes, il cherche pendant un quart d’heure, je finis par l’arrêter. Au bout de 33 minutes, je n’avais aucune image et 39 % de batterie en moins, soit environ 71 watts tirés en moyenne.
L’explication est venue au sol. Le contexte sert de mémoire de travail au modèle, et cette mémoire est réservée entièrement dès le chargement, même si elle n’est pas utilisée. Or, à chaque démarrage, Hermes choisit la plus grande fenêtre possible, 262 144 tokens, l’équivalent de plusieurs livres.
Avec le modèle, elle engage environ 40 Go de mémoire vidéo. Avec ComfyUI à côté, la mémoire que Windows accepte d’engager, plafonnée à 60,7 Go sur ma machine, sature, et le modèle ne se charge plus. ComfyUI affichait pourtant encore « 55 Go de mémoire vidéo libre » : sur cette puce, ce chiffre est trompeur.
Hermes refuse de descendre sous 64 000 tokens. Il a fallu régler le contexte à 65 536 tokens. J’ai donc réduit la capacité du modèle à raisonner longuement ou à traiter de grandes quantités de données.
Le modèle n’occupe alors plus qu’environ 24 Go, et l’agent et le logiciel d’images tiennent enfin ensemble. Petit aparté : avec la version 128 Go du ProArt P16, je n’aurais pas eu besoin de réduire le contexte du modèle.

La même demande aboutit alors, sans aide : Hermes écrit le prompt, lance ComfyUI et rend l’image. L’agent en fait toutefois un peu trop : après la génération, il passe un long moment à revérifier son travail dans le terminal, et l’une de ses commandes a été bloquée par sa propre sécurité. Dommage, je n’avais pas encore la nouvelle version de Windows qui permet justement d’approuver automatiquement les commandes jugées non dangereuses, comme celle-ci.
L’agent local marche donc, mais pas en deux clics, et en réglant la mémoire à la main. Sur une tâche plus lourde, avec davantage d’outils et un long contexte, 64 Go ne suffiront pas. C’est là que la version 128 Go prend son sens.
Cinquième et sixième tâches : coder un petit jeu, générer une vidéo
Microsoft a montré sur scène GitHub Copilot qui continue à coder en mode avion, avec son nouveau modèle local MAI Code 1.1 Flash. Impossible à refaire ici : Microsoft recommande plus de 120 Go de mémoire pour ce modèle.

J’ai pris à la place Qwen3 Coder, qui tient dans 64 Go, et je lui ai demandé un petit jeu sur le thème du vol : un avion en papier qu’on déplace pour éviter les turbulences et les nuages. Ce n’est pas la folie visuellement, mais il fonctionne, et le code sort à environ 95 tokens par seconde.
Dernier défi, le plus gourmand : générer une vidéo avec MiniMax H3, le modèle chinois que Nvidia mettait en avant sur scène. J’ai utilisé la version officielle proposée pour ComfyUI, un logiciel de génération d’images et de vidéos qui tourne sur la machine, sans agent : le modèle vidéo y est compressé en INT8, seul son encodeur de texte profite du format NVFP4 de Nvidia.

La veille du vol, à l’hôtel, l’essai a fonctionné : une scène de cabine, de nuit, avec le bruit des moteurs, soit cinq secondes de vidéo avec le son, en un peu plus de quatre minutes, en petite définition (864 × 480). Mais le logiciel garde ensuite environ 40 Go de mémoire pour lui. En vol, avec Hermes qui tournait à côté, il a planté. Sur 64 Go, il faut faire une chose à la fois.
Batterie, chaleur, bruit : le vrai prix de l’IA locale
La batterie pose bien plus de problèmes que la vitesse. Elle fait 99,9 Wh, juste sous la limite de 100 Wh au-delà de laquelle il faut l’accord de la compagnie pour l’emporter en cabine.
| Usage | Ce que j’ai observé | Autonomie au même rythme |
|---|---|---|
| Questions, résumés, transcription | de 100 à 78 % en une heure, environ 20 W | environ 5 heures |
| Agent Hermes et ComfyUI | 39 % en 33 minutes, environ 71 W | moins d’1 h 30 |
| IA intensive en mode Performance (mesuré à Paris) | 75 W en moyenne, jusqu’à 100 W | environ 1 h 15 |
Relevés pendant mon usage, à partir de la baisse réelle de la batterie.
Une heure de questions et de résumés, ça passe très bien. Un agent qui travaille, c’est une heure et quart au mieux, comme les PC portables de jeu d’il y a quelques années. Pour de longues sessions, il faut une prise et une table. La prise de l’avion ne suffit pas non plus : branché sur le siège, en plein calcul, j’ai quand même perdu 13 % de batterie en 19 minutes. Il faut dire que le bloc secteur fait 140 watts, alors que la prise de mon siège devait en sortir à peine 60.

Deux pièges m’attendaient aussi. Si l’écran s’éteint, Windows passe en veille et bride la puce : les calculs continuent, deux à trois fois plus lentement (le code de mon jeu est passé de 93 à 34 tokens par seconde). Écran réglé sur « Jamais », donc.
Plus brutal, à 30 % de batterie, la vitesse est divisée par deux d’un coup : gpt-oss-20b passe de 78 à 38 tokens par seconde, Qwen 3.8 27B de 26 à 11, alors que le GPU reste occupé à 94 %. Ulrich a reproduit ce bridage et y a trouvé un coupable, l’économiseur d’énergie de Windows, réglé d’usine pour s’activer à 30 % : en le passant sur « Jamais », il récupère l’essentiel de la vitesse. Sur ma machine, il était pourtant déjà désactivé, ce qui laisse penser qu’un second mécanisme peut entrer en jeu.

Côté chaleur, rien d’inquiétant pour la puce : le GPU n’a jamais dépassé 71 °C ni ralenti à cause de la température. Ce sont les genoux qui prennent. Le bruit est celui d’un PC de jeu : Ulrich a mesuré jusqu’à 65 dB à un mètre dans Cyberpunk 2077 en 4K. Ce que je décris vaut pour cet Asus : chaque constructeur règle la puissance de la puce entre 45 et 80 watts, et d’autres châssis pourraient faire mieux.
Et face au MacBook Pro ?
Quand j’ai réalisé les tests, je ne savais pas ce que donnait un Mac. Ulrich a depuis fait passer les mêmes épreuves à un MacBook Pro M5 Pro en 48 Go et à la version 128 Go du ProArt P16.
| RTX Spark (ProArt P16 128 Go) | MacBook Pro M5 Pro 48 Go | |
|---|---|---|
| Écriture, Qwen 3.6 35B | 74,8 tokens/s | 68,7 tokens/s |
| Lecture d’un long texte (16 384 tokens, Qwen3-8B) | 6,3 s | 19 s |
| IA continue sur batterie | environ 64 min | environ 66 min |
| Énergie pour 1 000 tokens écrits | 0,36 Wh | 0,27 Wh |
| Vitesse sous 30 % de batterie | divisée par deux (réglage d’usine) | inchangée jusqu’à 5 % |
| gpt-oss-120b (63 Go) | 63,3 tokens/s | ne se charge pas |
Mesures d’Ulrich, mêmes fichiers de modèles. Autonomies estimées de 100 à 0 % au rythme mesuré.
En écriture, les deux machines font jeu égal, leurs bandes passantes mémoire étant proches. La RTX Spark prend l’avantage dès que le calcul compte : elle lit un long document 2,5 à 3 fois plus vite, un atout pour les agents qui relisent sans cesse des fichiers. Sur batterie, l’autonomie est la même, environ une heure d’IA continue, mais le Mac consomme environ 25 % d’énergie en moins pour écrire le même texte (0,27 Wh contre 0,36 Wh pour 1 000 tokens).
Bonne nouvelle pour mon exemplaire : à fichiers comparables, la version 64 Go écrit aussi vite que la 128 Go. Les 128 Go servent à charger des modèles plus gros, sans gain de vitesse.
Ce que je perds avec 64 Go
Pour mesurer l’écart, j’ai repris l’indice d’Artificial Analysis, un classement indépendant que Nvidia cite lui-même. Plus l’indice est élevé, plus le modèle est intelligent et performant.
| Modèle | Mémoire nécessaire | Indice Artificial Analysis |
|---|---|---|
| gpt-oss-120b (OpenAI) | 128 Go | 12 |
| Qwen 3.8 27B (Alibaba), réflexion maximale | 64 Go | 34 |
| Qwen 3.8 Flash-Next (Alibaba) | 128 Go | 40 |
| Claude Sonnet 5.5 medium (cloud) | – | 41 |
| Claude Opus 5.5 max (cloud) | – | 58 |
Relevé du 9 octobre 2026
Il y a un an, la star de l’IA locale en 128 Go, c’était gpt-oss-120b, à 12. Le Qwen 3.8 27B qui tient dans mes 64 Go monte à 34 : presque trois fois mieux, dans quatre fois moins de mémoire. Je ne perds vraiment qu’un modèle, Qwen 3.8 Flash-Next, la vitrine de Nvidia, avec 125 milliards de paramètres. Il est à 40, au niveau de Claude Sonnet 5.5 en réglage intermédiaire selon Nvidia.
L’IA locale atteint le niveau du cloud d’il y a six mois. Le nouveau modèle maison de Nvidia, Nemotron 3.5 Bolt, tient en revanche dans mes 64 Go : 74 milliards de paramètres dont 9 milliards actifs, environ 24 Go en quantification 2 bits, et entièrement ouvert. Nvidia l’a publié ce jeudi 15 octobre, après mes essais, et je n’ai pas encore pu l’essayer. Il se lance dès maintenant dans LM Studio, Ollama ou llama.cpp, et Nvidia annonce un accès direct depuis Hermes.

Ne comptez pas non plus sur un second PC pour combler l’écart. Nvidia lance PAIR, un outil gratuit et open source qui répartit le travail des agents entre les ordinateurs de la maison, PC et Mac, testé jusqu’à seize appareils. Mais il n’additionne pas la mémoire : chaque tâche part sur une seule machine. Deux PC de 64 Go ne font pas une IA de 128 Go.
Mais l’outil reste intéressant : votre PC portable du quotidien peut faire tourner un petit modèle, et quand il a besoin de plus de puissance, il fait appel à un autre ordinateur de la maison, plus puissant.
Je n’ai pas eu le temps d’explorer une dernière piste : Linux, moins gourmand en mémoire que Windows, laisserait davantage de place au GPU. C’est ce que fait déjà le DGX Spark, la machine de Nvidia très proche vendue sous Linux.
5 299 €, rentable ?
Nvidia met en avant un autre argument : le PC devient un « générateur de tokens ». Selon sa diapositive, 61 millions de tokens écrits par mois coûtent 20 dollars (environ 17 €) d’électricité en local, contre 1 200 dollars (environ 1 030 €) facturés par l’API d’un modèle du cloud comparable. La note de bas de page précise les conditions : un mini PC RTX Spark à 200 watts en moyenne, qui calcule près de 20 heures par jour, comparé au tarif à l’usage des développeurs. Ce calcul vise ceux qui font tourner des agents jour et nuit, pas l’abonné à ChatGPT Plus.
Pour lui, le calcul est vite fait. À 23 € par mois, mon ProArt 64 Go représente environ dix-neuf ans d’abonnement. Les 2 300 € qui séparent la version 64 Go de la version 128 Go (7 599,99 € avec 2 To) valent à eux seuls plus de huit ans de ChatGPT Plus, alors que la machine restera la même, quand l’abonnement profite des nouveaux modèles et des serveurs renouvelés d’OpenAI. Sur un portable, l’électricité est dérisoire, 2 à 3 centimes la batterie pleine. Le vrai coût se paie en autonomie et en temps.

La confidentialité est l’argument qui tient. Même avec une offre professionnelle qui promet de ne pas entraîner les modèles sur vos données, celles-ci partent dans le cloud et y sont conservées un temps. Pour des documents d’entreprise ou personnels, l’IA locale reste la seule à tout garder sur la machine.
L’approche hybride de Nvidia et Microsoft me plaît aussi : garder en local ce qui est confidentiel, envoyer au cloud ce qui demande de la puissance. Nvidia annonce un routeur de ce type, NeMo Switchyard, en bêta dans Hermes d’ici fin octobre. Aujourd’hui, c’est encore de la bidouille.
Quelle version pour quel usage
Nvidia range lui-même les versions 24 et 32 Go sous « jeux, création et agents avec des modèles du cloud ». Asus propose aussi une version 48 Go. Mon expérience donne ce découpage :
- 24 et 32 Go : jeux, création, et un agent dont le cerveau reste dans le cloud ;
- 64 Go : discuter, résumer, transcrire, coder et générer des images ; un agent avec un logiciel d’images à côté, à condition de régler sa mémoire à la main ;
- 128 Go : le meilleur modèle local du moment, la vidéo, et les agents qui enchaînent de nombreux outils sur de longues sessions.
Pour le jeu, la RTX Spark se comporte comme une RTX 5070 portable, avec les contraintes de l’émulation des jeux x86 et des anti-triches pas encore compatibles : Ulrich détaille tout cela dans son test.
ChatGPT peut-il rester à terre ?
Pas complètement. Les modèles qui tiennent dans 64 Go n’ont pas le niveau des meilleurs modèles du cloud, et l’agent, la partie la plus prometteuse, n’a rien produit en plein vol et a demandé un réglage à la main pour fonctionner.

Mais pour l’usage que la plupart des gens ont de ChatGPT, poser des questions, résumer un document, transcrire un enregistrement, l’IA locale fait le travail, vite, et sans qu’aucune donnée ne quitte la machine. Il y a quelques semaines, je considérais encore l’IA locale comme dépassée. Avec la bonne configuration et les bons modèles, j’ai pris une claque.
Les limites sont ailleurs : le prix, la mémoire, et une batterie qui tient à peine plus d’une heure quand l’IA travaille vraiment. Tout cela est vrai en octobre 2026. Les modèles progressent tous les deux mois, et ceux qui tiendront dans 64 Go dans six mois feront peut-être la vidéo qui a planté dans mon avion.